Jev AI 작동 원리: 선택과 확률로 판단하는 System One 모델
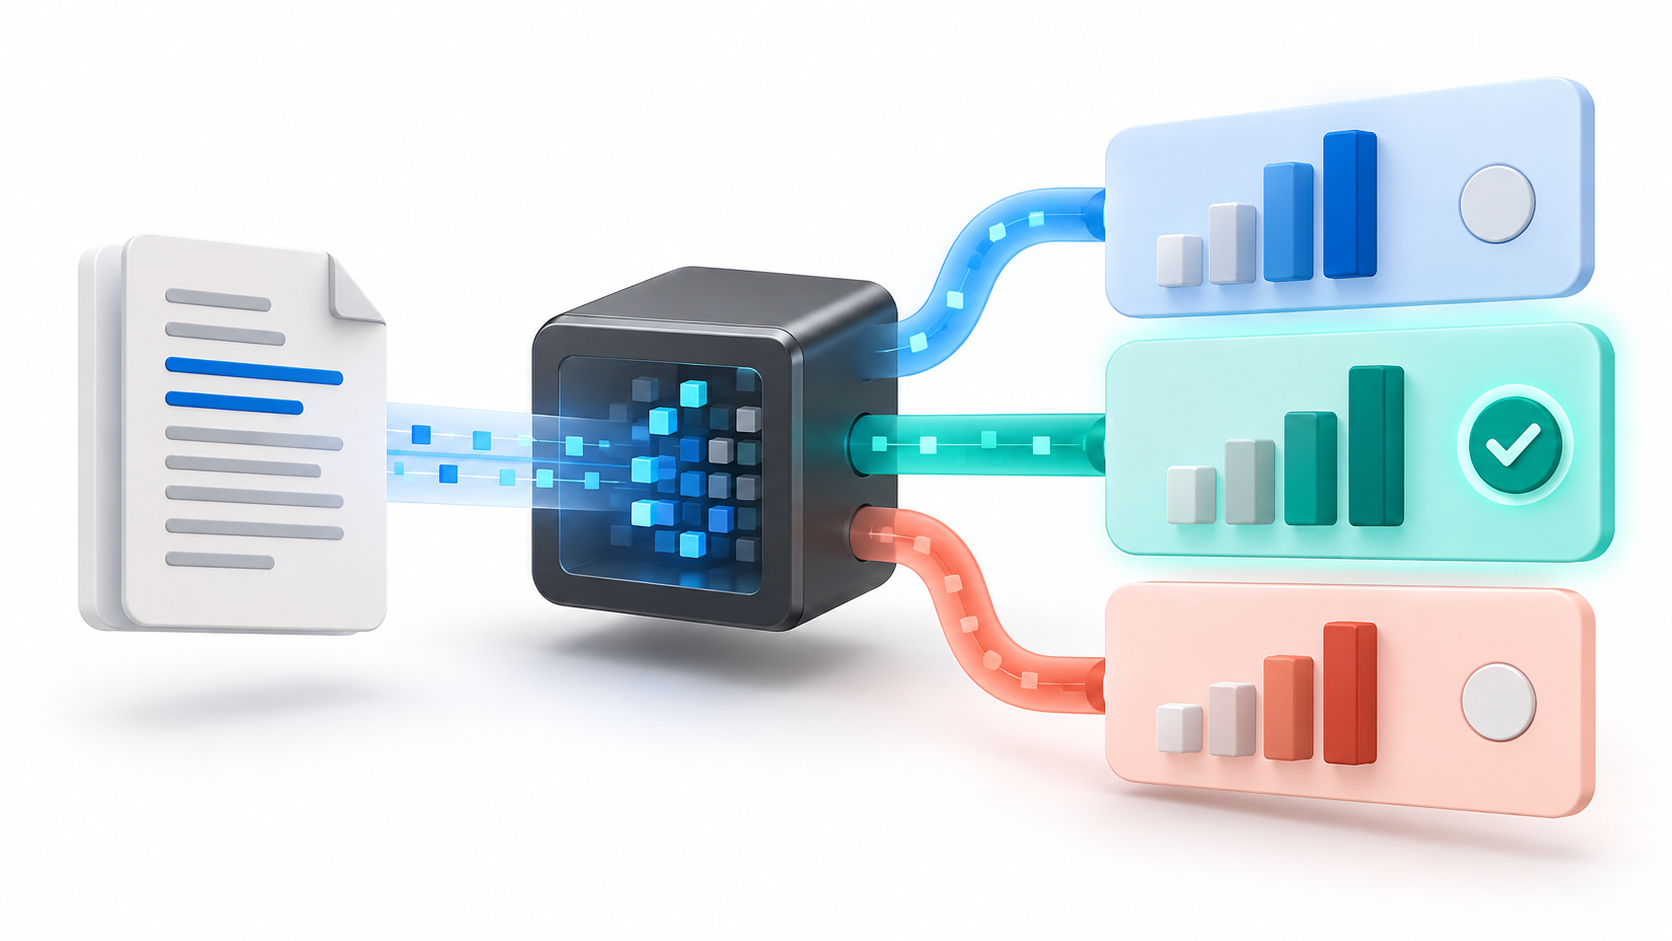
Jev는 TypeSafe AI의 의사결정 모델입니다. 문장을 생성하는 대신 정해진 선택지와 점수, 확률을 반환합니다. 따라서 문의 분류처럼 프로그램이 결과를 받아 다음 행동을 정하는 작업에 쓰입니다.
Jev를 이해하려면 확률과 confidence를 구분해야 합니다. 또한 출력 형식을 지킨다는 사실이 판단의 정확성을 보장하지는 않습니다.
Jev는 무엇이며 LLM과 어떻게 다른가요?
안녕하세요! 기술의 원리와 활용법을 소개하는 OCstory입니다. 고객 문의를 담당 부서에 배정하려면 먼저 문의 유형을 알아야 합니다. Jev는 이런 판단을 소프트웨어에 전달하도록 설계된 모델입니다.
1. System One이라는 이름의 의미
TypeSafe AI는 2026년 9월 15일 Jev를 초기 접근 형태로 공개했습니다. System One이라는 이름은 System 1 개념에서 따왔습니다. 빠르고 직관적인 판단을 가리키는 말이며 사람의 뇌 구조를 그대로 구현했다는 뜻은 아닙니다. 출처: TypeSafe AI 출시 발표
2. 문장 생성과 판단의 역할 구분
LLM도 구조화된 출력으로 분류 작업을 처리합니다. 그래서 JSON을 반환한다는 이유만으로 Jev와 LLM을 구분하기는 어렵습니다. Jev는 자유로운 텍스트 생성을 포기하고 제한된 판단과 확률을 반환하는 데 초점을 맞춥니다. 출처: 공식 소개
두 모델을 함께 쓰는 방법도 있습니다. Jev가 문의 유형을 고르면 생성형 모델이 해당 유형에 맞는 답장을 작성하는 방식입니다. 이때 분류와 문장 작성의 오류를 따로 살펴볼 수 있습니다.
입력과 출력은 어떻게 구성되나요?
1. 판단할 자료와 질문을 분리
state는 판단할 자료이며 questions는 그 자료에 대한 질문입니다. 고객 문의를 state로 넣고 담당 부서와 긴급성을 questions로 물을 수 있습니다.
Choice는 정해진 선택지 중 하나를 고릅니다. Score는 순서가 있는 평가 기준에 따라 점수를 반환합니다. Noul은 명제가 참일 확률을 0부터 1 사이 값으로 표현합니다. 출처: 질문 유형 설명
예를 들어 담당 부서는 Choice로 분류합니다. 불만 강도는 Score로 평가하고 긴급한 요청인지는 Noul로 묻습니다. 질문을 나누면 어느 판단에서 문제가 생겼는지 찾기 쉽습니다.
2. 같은 자료를 기준으로 질문을 병렬 평가
공식 문서에 따르면 여러 질문은 같은 state를 기준으로 독립적으로 평가됩니다. 질문 B가 같은 호출에 포함된 질문 A의 답을 읽는 구조는 아닙니다. 앞선 결과에 따라 다음 질문이 달라진다면 응답을 받은 뒤 후속 요청을 보내야 합니다. 출처: 병렬 평가 설명
RLCD와 확률 보정은 무엇인가요?
1. 판단과 확률을 학습하는 RLCD
TypeSafe AI는 학습 방식을 RLCD라고 부릅니다. Reinforcement Learning for Calibrated Decisions의 약자이며 판단과 보정된 확률을 반환하도록 학습한다는 설명입니다. 공개 자료는 이 목표를 소개하지만 내부 학습 절차 전체를 제시하지는 않습니다. 출처: 공식 AI Primer
2. 예측 확률과 실제 발생 비율 맞추기
확률 보정은 예측한 확률과 실제 발생 비율이 얼마나 일치하는지 살피는 개념입니다. 0.8로 예측한 사례를 모았을 때 해당 결과가 약 80%에서 발생한다면 그 구간의 확률이 잘 보정됐다고 봅니다. 개별 예측의 정답을 보장하는 개념은 아닙니다. 출처: 확률 보정 설명
자신의 데이터에서도 검증해야 합니다. 한국어 문의나 업종별 전문 용어가 포함된 자료를 평가하세요. 특히 높은 확률을 준 오답을 따로 살펴보는 것이 좋습니다.
confidence가 높으면 정답인가요?
1. confidence는 확률 분포의 요약값
Choice와 Score의 confidence는 확률 분포를 요약한 값입니다. 실제 정답률을 별도로 측정한 수치가 아닙니다. Noul은 별도 confidence 없이 참일 확률을 반환합니다. 출처: 공식 Confidence 문서
Choice의 공식 계산식은 (p − 1/n) ÷ (1 − 1/n)입니다. 여기서 n은 선택지 수이며 p는 가장 높은 확률입니다. 선택지가 3개이고 최고 확률이 0.8이면 confidence는 0.7입니다. 이를 정답 확률 70%로 해석하면 안 됩니다. Score에는 다른 계산식이 적용됩니다.
2. 형식이 맞아도 분류는 틀릴 수 있다
출력이 정해진 형식을 지켜도 판단은 틀릴 수 있습니다. 결제 문의를 기술 문의로 분류하면 형식상 오류는 없지만 업무 판단은 잘못된 것입니다. 따라서 애매한 결과를 검토로 보내는 경로가 필요합니다.
자주 묻는 질문 (FAQ)
Jev가 블로그 글도 쓰나요?
자유로운 문장 생성은 Jev의 역할이 아닙니다. 글 작성에는 생성형 모델을 사용하고 Jev에는 분류나 점검을 맡기는 구성이 적합합니다.
복잡한 판단을 질문 하나로 맡겨도 되나요?
긴급성과 정책 적합성처럼 판단 요소를 나누는 편이 좋습니다. 이후 프로그램의 규칙으로 결과를 결합하면 오류 원인을 찾기 쉽습니다.
자료 확인 기준: 2026년 10월 9일.